日本語医療文書から100万件超のQAを構築
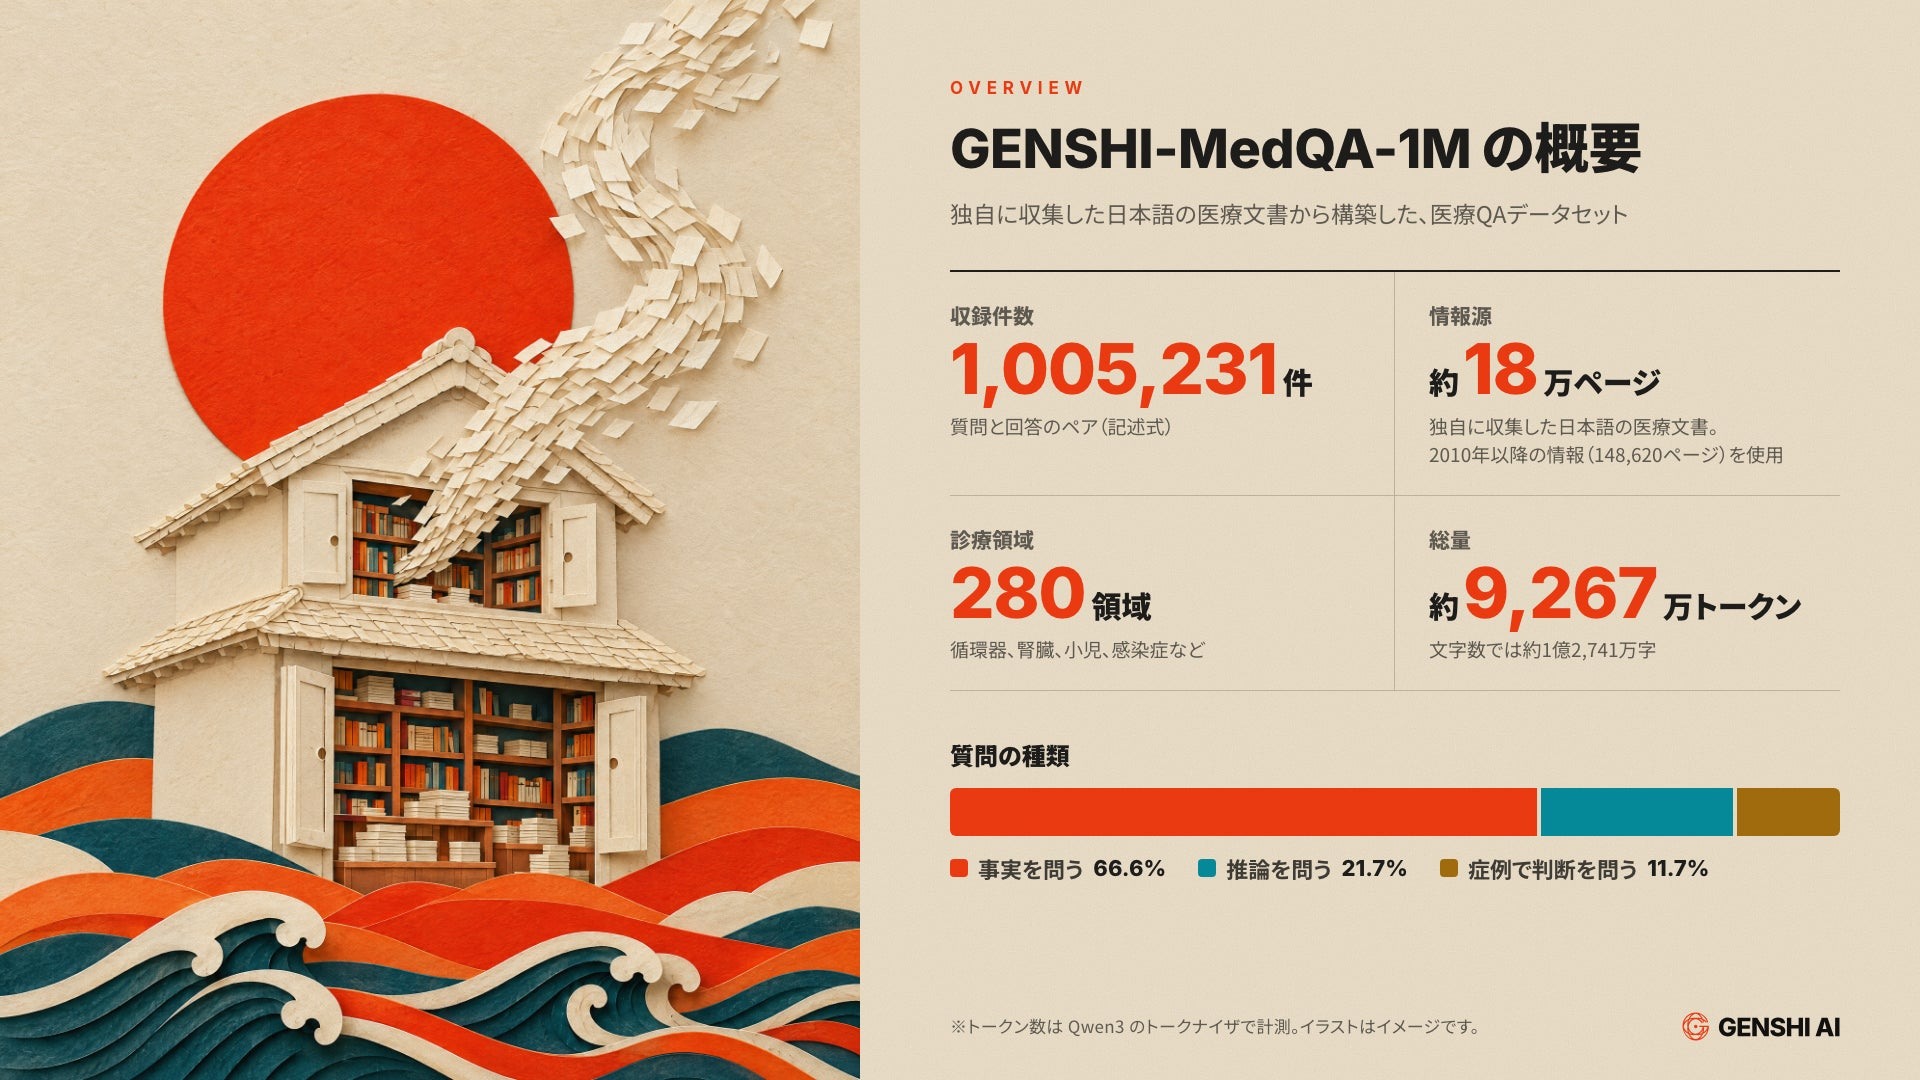
株式会社GENSHI AIは2026年10月15日、日本語の医療QAデータセット「GENSHI-MedQA-1M」を公開した。独自に収集した日本語の医療文書をもとに、生成AIで質問と回答を合成した記述式のデータセットである。
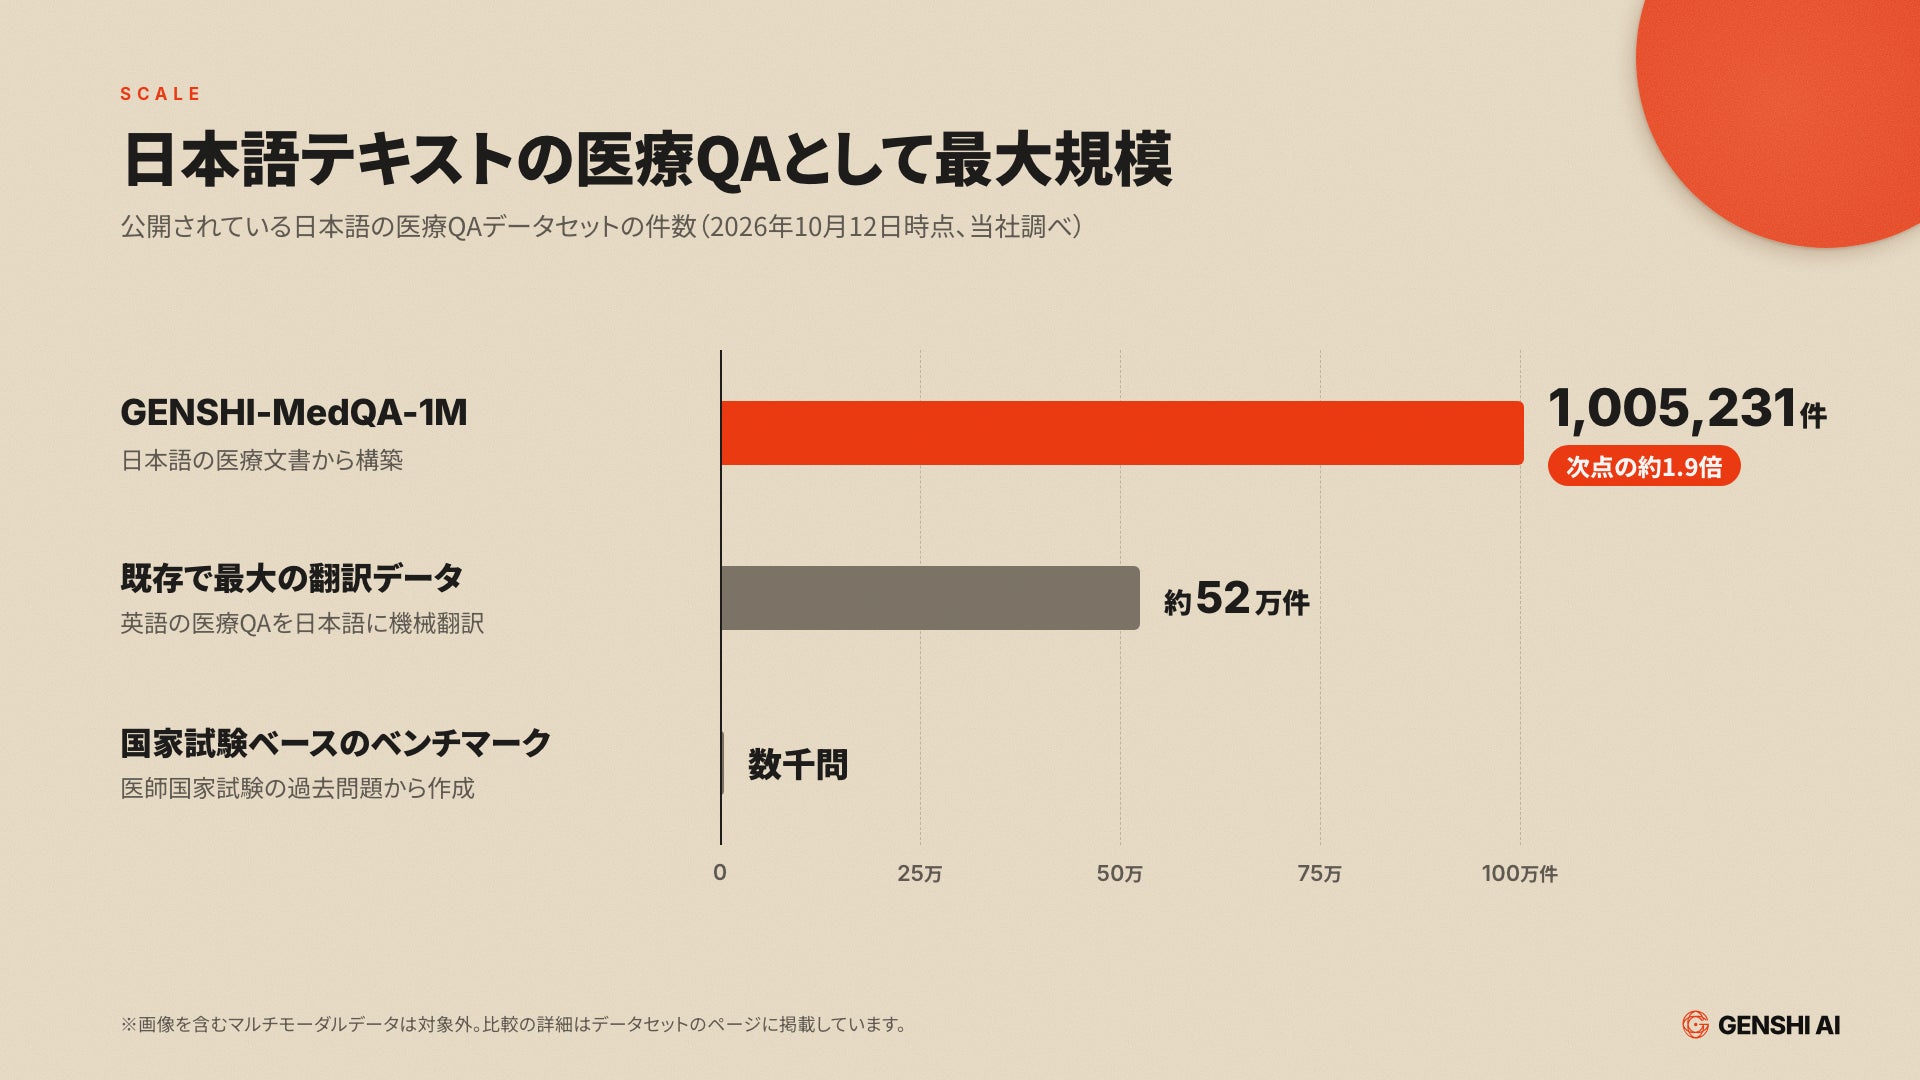
収録件数は100万5,231件で、約1億2,741万字、約9,267万トークンに相当する。情報源は17万9,479ページの医療文書のうち、2010年以降の情報を含む14万8,620ページ。質問は、事実を問うものが66.6%、推論を問うものが21.7%、症例を示して判断を問うものが11.7%で構成される。
同社は、公開されている日本語テキストの医療QAデータセットとして最大規模だとしている。2026年10月12日時点の同社調べで、英語の医療QAを機械翻訳した約52万件のデータセットと比べて約1.9倍の規模という。画像を含むマルチモーダルデータは比較対象に含まれない。
非商用研究に限定し申請後に提供
利用対象は、大学・研究機関、医療機関、企業の研究開発部門などによる非商用研究だ。利用希望者はデータセットのページで氏名、所属、利用目的などを入力し、同社の確認と承認を受ける。営利目的での利用やモデル学習は対象外となる。
データは生成AIで合成され、同社は、診断や治療の判断、患者への助言には使用しないよう求めている。
医療機関が研究利用する場合は、非商用という利用条件に加え、収録内容の検証範囲と用途の制限が前提となっている。
出典
- 情報元:PR TIMES
- 掲載日:2026年10月15日
- 記事名:GENSHI AI、100万件超の日本語医療QAデータセット「GENSHI-MedQA-1M」を公開。日本語テキストの医療QAとして世界最大規模
医療機関向けの情報発信を行う一般社団法人 DOC TOKYOの編集部門として、クリニック運営・医療業務・医療ITに関する情報を調査・編集しています。
医療機関やサービス提供事業者への取材、公開情報の確認、製品・サービス情報の整理を通じて、医療現場の実務と経営判断に役立つ比較・検討材料を提供しています。
- メルマガで最新情報に簡単アクセス
クリニック経営に役立つ最新情報をお届け! - 開業に役立つ記事・動画が見放題
DOCWEB限定動画や厳選された情報で、円滑な開業準備をサポート! - クリニックに合った製品・サービスがすぐに見つかる
手間なく、効率的に情報収集。DOCWEBならではの充実した比較・検討が可能! - 気になる製品・サービスの資料を無料ダウンロード
詳細情報をすぐに確認でき、納得の選択ができる!